Vision#vision par ordinateur#yolo#opencv
Reconnaissance d'image ou YOLO : comment votre bot doit-il trouver un bouton ?
Le template matching est gratuit et fragile. Un détecteur entraîné coûte un dataset et survit aux refontes. Guide de décision concret, avec les modes de panne de chacun et le vrai prix du changement.
Les deux approches répondent à la même question — où se trouve sur cet écran la chose que je veux toucher ? — et elles échouent de façons complètement différentes. Se tromper coûte soit une semaine de travail de dataset inutile, soit un bot qui casse un mardi sur deux.
Ce que fait réellement le template matching
cv2.matchTemplate fait glisser une image de référence sur une capture d'écran et note la ressemblance à chaque position. Le meilleur score au-dessus de votre seuil est votre correspondance. C'est de l'arithmétique, pas de l'apprentissage : aucun entraînement, aucun dataset, un résultat en quelques millisecondes.
Ce qui décrit aussi ses limites. Il compare des pixels, donc tout ce qui change les pixels le casse :
- Le redimensionnement. Un template capturé en 1080×2340 ne correspondra pas au même bouton sur un écran 720×1600. Soit vous gardez un template par résolution, soit vous redimensionnez à la volée et perdez en précision.
- La compression. Les captures tirées d'un flux avec perte prennent des artefacts autour des contours contrastés — exactement là où vivent les boutons.
- Le thème. Le mode sombre change presque tous les pixels du template alors que le bouton reste, pour vous, parfaitement reconnaissable.
- L'animation. Un appel à l'action qui pulse est une image différente à chaque trame.
- Les superpositions. Un badge, une infobulle ou un curseur par-dessus la cible fait tomber le score sous le seuil.
Aucun de ces points n'est fatal isolément. Ensemble, ils expliquent pourquoi un bot en template matching a un coût de maintenance qui grandit avec le nombre d'apps et d'appareils qu'il touche.
Ce qu'un détecteur entraîné fait différemment
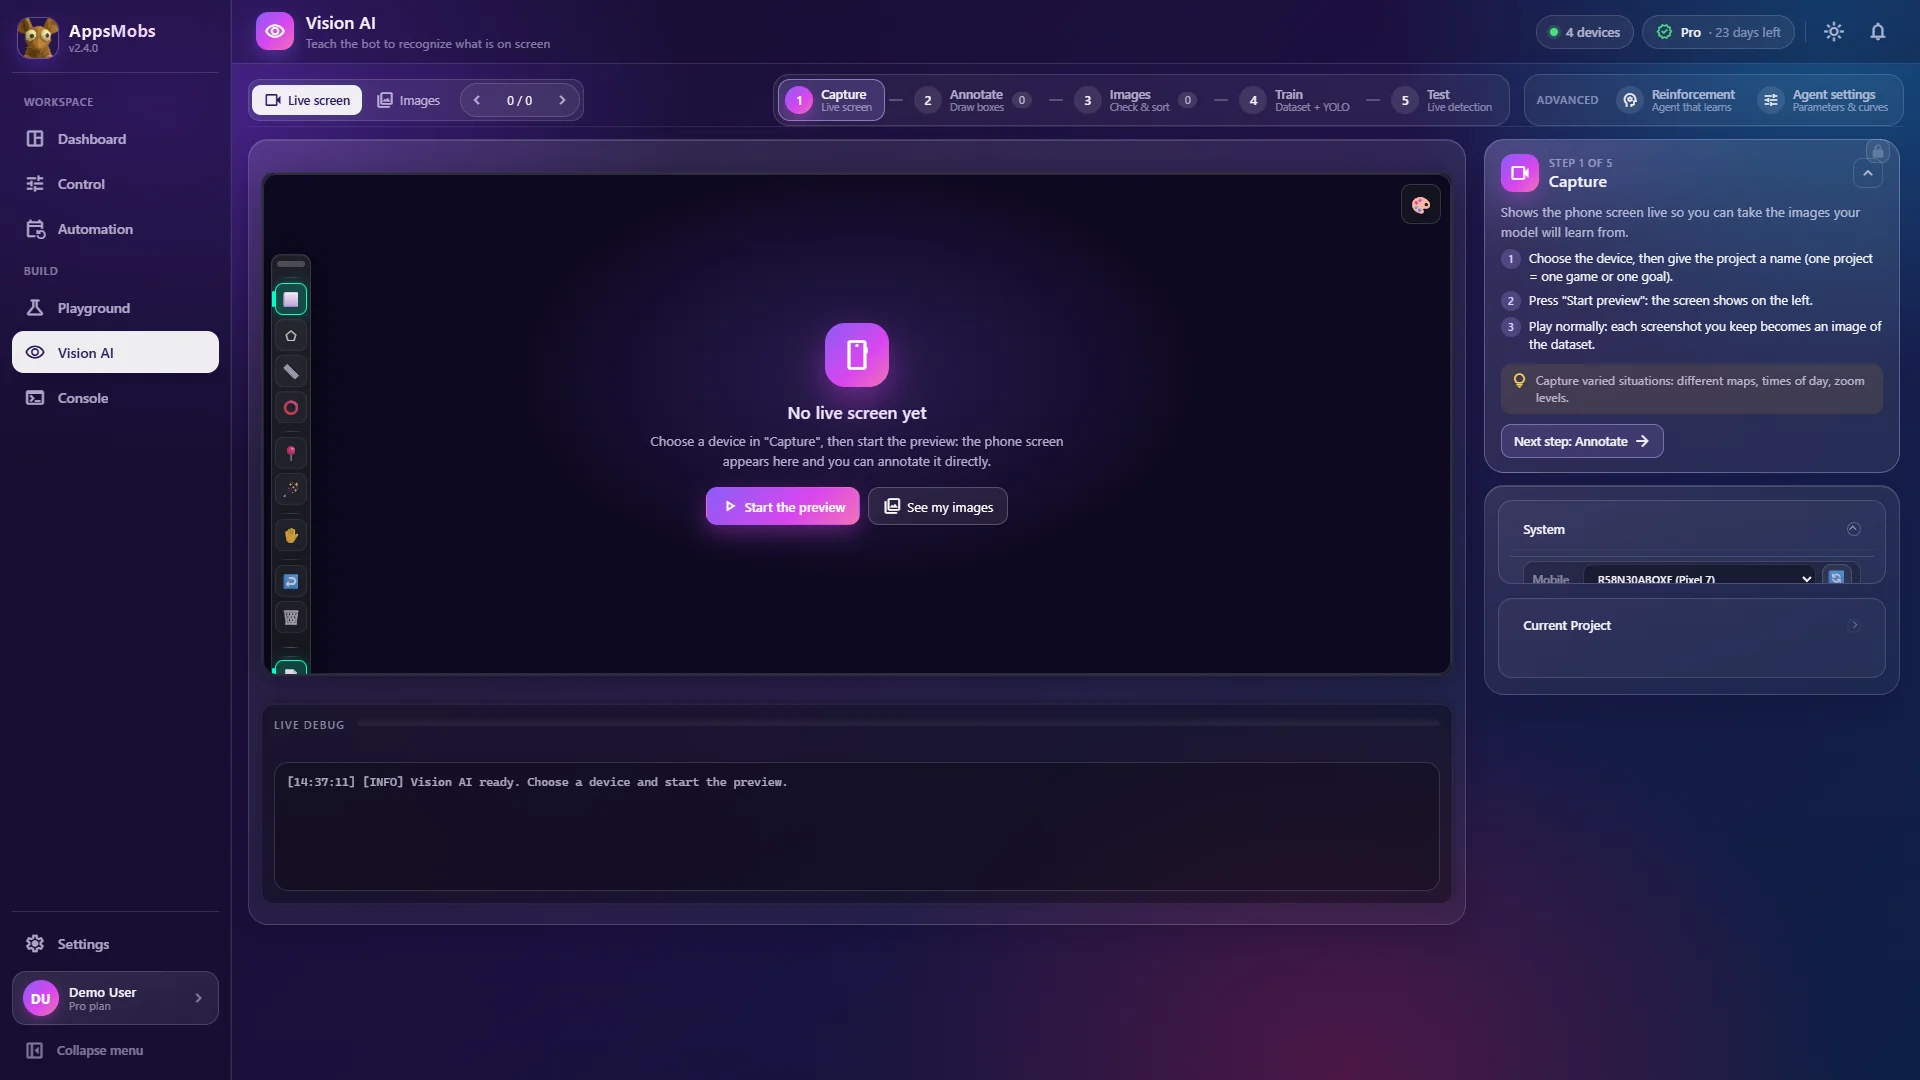
Un modèle YOLO apprend à quoi la classe ressemble, à travers les variations que vous lui avez montrées. Avec trente à cinquante captures variées où la cible est encadrée, il la trouvera à une autre taille, dans un autre thème, en pleine animation, partiellement masquée, sur un format d'écran qu'il n'a jamais vu.
Il renvoie des boîtes avec un score de confiance plutôt qu'une seule meilleure position, ce qui compte plus qu'il n'y paraît : une liste de candidats permet de prendre le plus sûr, de compter les occurrences, ou d'essayer jusqu'à ce que ça marche.
boxes = model.detect(device.screenshot(), classes=["claim"], confidence=0.8)
for box in sorted(boxes, key=lambda b: -b.confidence):
    device.tap(box.center)
    if device.wait_for_text("Collected", timeout=6):
        break
Le coût est réel et mérite d'être dit : il faut capturer des images, dessiner des boîtes, lancer un entraînement, et ré-entraîner quand une variation vraiment nouvelle apparaît. Sur CPU, c'est quelques minutes ; sur GPU CUDA, quelques secondes.
La décision, en un tableau
| Situation | Choisissez |
|---|---|
| Icône fixe, un seul modèle d'appareil, app stable | Template matching |
| L'app expose une hiérarchie de vues | uiautomator dump — ni l'un ni l'autre |
| La cible est un libellé ou un nombre | OCR |
| Plusieurs tailles d'écran ou les deux thèmes | Détecteur entraîné |
| La cible s'anime, défile ou se déplace | Détecteur entraîné |
| Il faut compter ou localiser plusieurs occurrences | Détecteur entraîné |
| Jeu avec une interface en canvas | Détecteur entraîné |
| Il faut que ça marche dans dix minutes | Template matching, puis on verra |
Le réflexe honnête pour une nouvelle automatisation, c'est le template matching. L'essai est gratuit, et s'il tient une semaine sur vos appareils réels, vous vous êtes épargné le dataset. Changez quand vous vous surprenez à recapturer des templates plus d'une fois.
Ce que « trente images » veut vraiment dire
Tout le monde demande combien d'images il faut, et le nombre compte moins que la diversité. Trente images montrant le bouton dans trente contextes réellement différents battent cinq cents captures quasi identiques d'une seule session, à chaque fois.
Variez volontairement :
- Deux ou trois modèles d'appareils, ou au moins deux résolutions
- Thème clair et thème sombre
- Plusieurs états d'arrière-plan — liste défilée, liste en haut, modale ouverte derrière
- Des images prises en pleine animation, pas seulement au repos
- Quelques négatifs : des écrans où la cible est vraiment absente
Annotez précisément. Une boîte qui inclut vingt pixels d'arrière-plan sur tous les exemples apprend au modèle que l'arrière-plan fait partie du bouton.
Le seuil de confiance est une décision produit
Un détecteur renvoie un score, et le seuil que vous acceptez arbitre entre deux types d'erreur.
Mettez-le haut — 0,9 et plus — et vous ratez de vraies cibles quand le rendu est légèrement différent : le bot se bloque. Mettez-le bas — sous 0,6 — et il clique sur des choses qui ne sont pas le bouton, ce qui, dans un tunnel de paiement, est nettement pire qu'un blocage.
Pour la plupart des boucles de récompense, 0,8 avec un réessai sur résultat vide est un bon point de départ. La bonne habitude est de journaliser le score de chaque détection sur laquelle vous agissez ; après une semaine, vous verrez la distribution réelle et pourrez régler le seuil sur des données plutôt que sur une intuition.
Là où les deux se rejoignent
Les meilleures automatisations utilisent les deux. Le template matching gère les parties statiques de l'interface — l'icône de réglages, la barre d'onglets, le bouton fermer — toutes stables au pixel près. Le modèle entraîné gère le seul élément qui bouge vraiment.
Cette répartition garde le dataset petit, le budget d'inférence bas, et la maintenance confinée à la partie qui change réellement.
Dans AppsMobs, les deux vivent derrière la même API de script — find_image() pour le premier, vision.detect() pour le second — donc déplacer une étape de l'un vers l'autre est un changement d'une ligne, pas une réécriture.